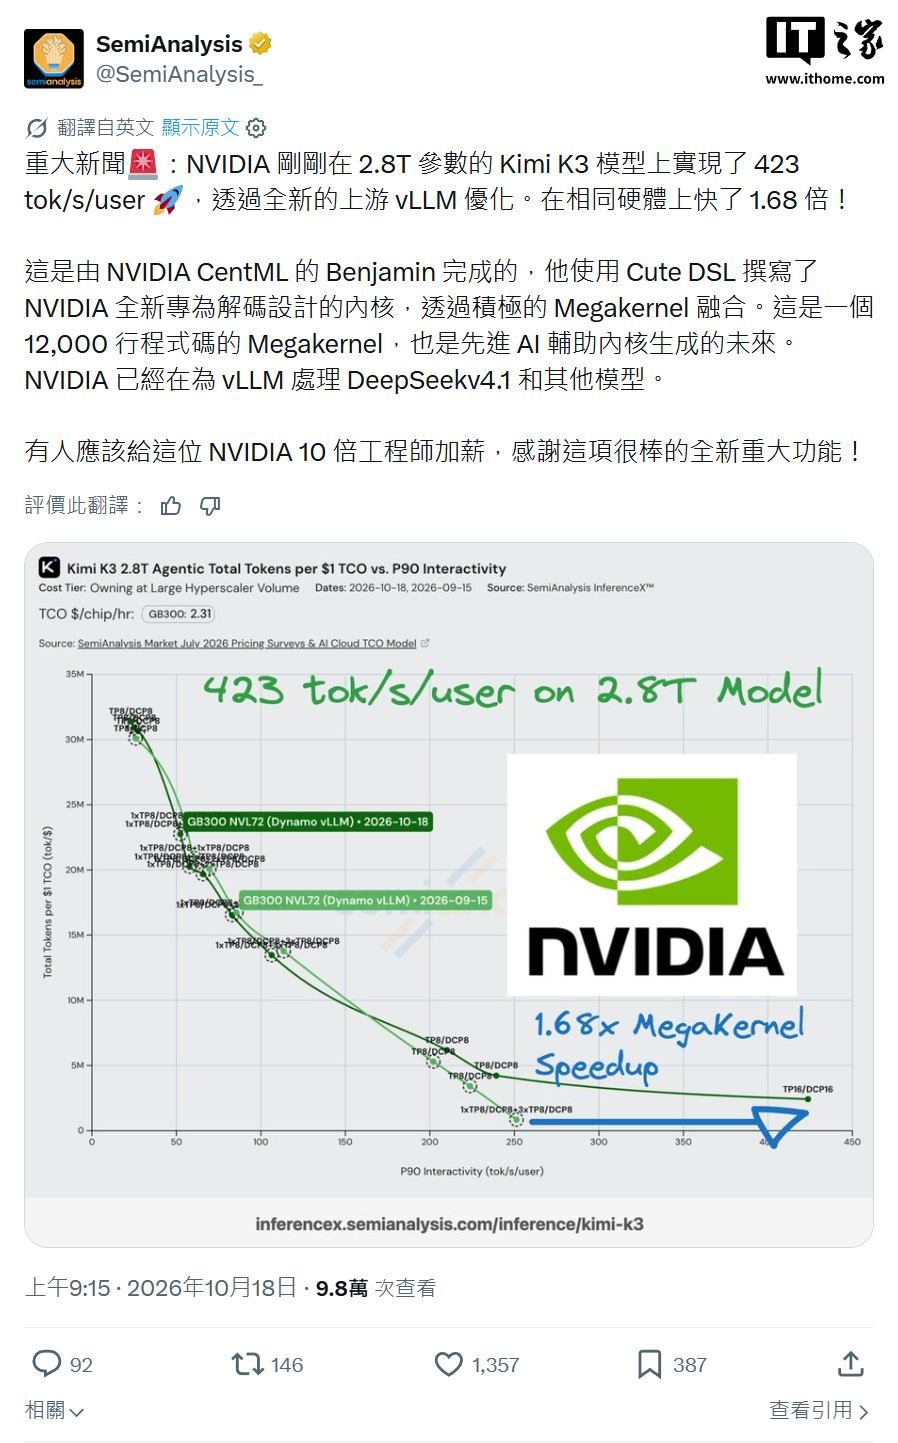
10 月 18 日,研究机构 SemiAnalysis 发布消息指出,英伟达利用一项针对上游 vLLM 的优化,使得参数规模达 2.8 万亿的 Kimi K3 模型达到每用户每秒 423 个 Token 的推理速率,与相同硬件配置(GB300 NVL72)相比,性能提高了 1.68 倍。
据悉,这项优化由英伟达 CentML 团队的工程师 Benjamin 负责实施。他通过大规模 Megakernel 融合技术,并运用 Cute DSL 编写了英伟达新推出的解码专用内核。该 Megakernel 包含 1.2 万行代码,这展示了 AI 辅助生成高级计算内核的发展方向。英伟达通过此举提升了 Kimi K3 模型的推理速度,增幅为 1.68 倍。
英伟达目前还在为 vLLM 推进 DeepSeek V4.1 等其他模型的优化工作。